← Главная новостей | Торговый зал
2026-11-03 · Источник:虎嗅·中继
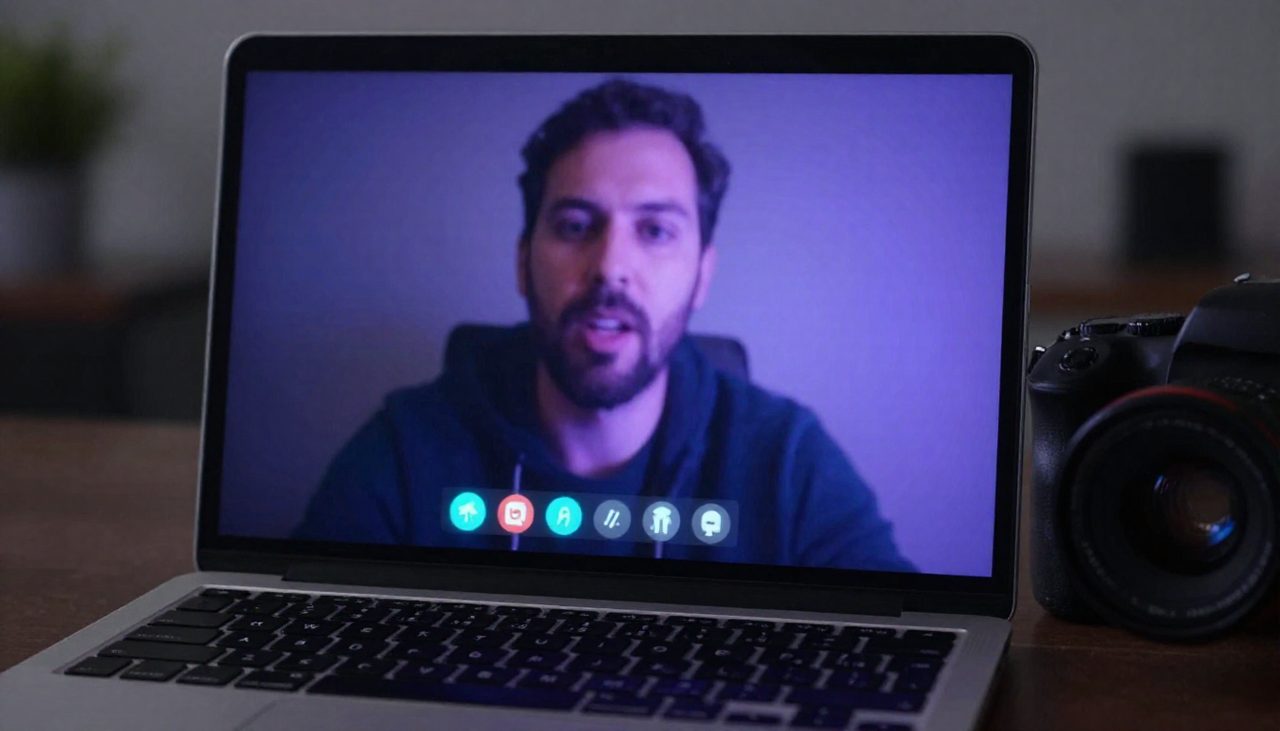
Логика «доверяй тому, что видишь» пошатнулась, но критерии теста определила сама Tavus, а превью пока доступно не всем
Сначала цифры — а потом разговоры о том, что «глаза не обманешь»: после минутного разговора с моделью Griffin-Lite (исследовательское превью Tavus) 26 из 54 участников решили, что по ту сторону экрана — живой человек, то есть около 48%; у предыдущей системы при том же протоколе из 41 человека обманулся лишь один, уровень ошибочного распознавания — 2,4%.
На этом основании Tavus объявляет Griffin первой моделью, прошедшей «видеотест Тьюринга» в реальном времени, и вводит для неё новую категорию — Human Interaction Model (модель человеческого взаимодействия, HIM). На момент публикации за экспериментом онлайн следили почти 17,36 млн пользователей. Однако «первенство» пока остаётся определением, которое Tavus дала собственному результату, модель ещё не открыта для широкого превью, и вероятность красиво разрисованной демо-версии исключать нельзя.
Настоящий технический интерес этого релиза — смена парадигмы взаимодействия: переход от каскадной архитектуры к полнодуплексной. Типичные каскадные системы выстраивают конвейер из распознавания речи, ответа языковой модели, синтеза речи и анимации цифрового аватара: система обрабатывает реплику пользователя только после того, как он закончил говорить. Griffin же, пока выдаёт звук и изображение, непрерывно принимает аудио- и видеопоток собеседника. Его движок моделирования непрерывного диалога с интервалом менее секунды заново оценивает состояние общения: по выражению лица, направлению взгляда, интонации и паузам собеседника решает, что сказать и когда вступить, и генерирует управляющие сигналы эмоций, мимики и движений, которые аудиовизуальный движок превращает в непрерывную картинку со звуком. Одну и ту же тишину модель должна различать: собеседник думает, уже договорил или ждёт продолжения объяснений — именно такие внеречевые детали чаще всего выдают ИИ с головой.
Расширяется и диапазон визуальной генерации. По словам Tavus, Griffin способен в реальном времени генерировать всю сцену по одному референсному изображению: лицо персонажа, руки, пальцы, движение стула, тени и изменения фона. Благодаря этому аватар может кивать, переводить взгляд или менять выражение лица ещё на этапе слушания, не дожидаясь, пока начнёт говорить. В официальных демонстрациях — игра на повторение команд, кубик Рубика и наблюдение за тем, как пользователь паяет печатную плату. Когда даже видео с камеры можно генерировать в реальном времени, предпосылку «открытое видео — последняя гарантия подлинности» приходится пересматривать.
Теги: Tavus · Griffin · Video Turing Test · Full-Duplex · Human Interaction Model · Digital Human
萬安算交所 AIXX · AIXX · Верифицированная биржа · В торговый зал